NVIDIA GeForce RTX 5070 Ti、16GB GDDR7メモリー搭載で大幅パワーアップ
2024年12月17日

NVIDIAは、AI推論性能を競うMLPerf Inference v4.1において、同社の最新テクノロジーを結集し、驚異的な結果を残しました。特に注目すべきは、初登場のNVIDIA BlackwellアーキテクチャがLlama 2 70Bモデルの推論では、NVIDIA H100 Tensor Core GPUの最大4倍もの性能を発揮したことです。
また、NVIDIA H200 Tensor Core GPUもすべてのデータセンターワークロードで力強い存在感を示し、H100比で最大1.5倍の性能向上を達成。ソフトウェアの最適化により、前回のプレビュー時から最大27%の性能向上を実現しました。
さらに、NVIDIA Triton Inference Serverを使ったLlama 2 70Bの初の結果提出では、NVIDIA TensorRT-LLMとほぼ同等の性能を実現。エッジ部門のGPT-Jベンチマークでは、NVIDIA Jetson AGX Orinプラットフォームを使用し、前回から最大6.2倍の性能向上を達成しました。
それでは、主要な結果を詳しく見ていきましょう。
2024年のNVIDIA GTCで発表されたNVIDIA Blackwellアーキテクチャは、AIスーパーチップの新時代を切り開く存在です。2080億トランジスタを搭載し、NVIDIAに最適化されたTSMC 4NPプロセスを採用した史上最大のGPUであるだけでなく、第2世代Transformer Engineを搭載。新しいBlackwell Tensor Coreテクノロジーと TensorRT-LLMの革新により、高速かつ正確なFP4 AI推論を可能にしています。
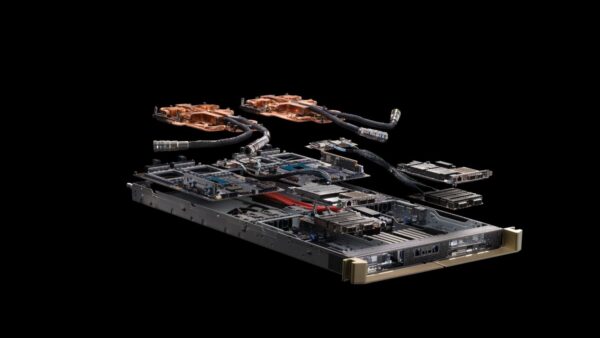
今回のMLPerf Inferenceで初登場したBlackwell(B200)は、Llama 2 70Bモデルの推論でH100の最大4倍の性能(1秒あたりのトークン数)を叩き出しました。この驚異的な結果は、Blackwell FP4 Transformer Engineを存分に活用したもので、モデルの変更なしでベンチマークの高い精度要件を満たしつつ、このような高性能を実現しています。
| Llama 2 70B | サーバー (tokens/s) | オフライン (tokens/s) |
|---|---|---|
| 1 NVIDIA B200 GPU | 10,756 | 11,264 |
| H100 に対する増加 | 4x | 3.7x |
NVIDIA H200 GPUは、業界最速のAIメモリHBM3eを搭載し、NVIDIA Hopperアーキテクチャを強化したものです。H100と比べ、メモリ容量が1.8倍、メモリ帯域幅が1.4倍に増加し、メモリ負荷の高いユースケースで威力を発揮します。
今回、NVIDIAはH200 GPU 8基を使用し、すべてのワークロードで好結果を出しました。特にLlama 2 70Bでは、1,000ワット構成のH200が34,864トークン/秒(オフライン)、32,790トークン/秒(サーバー)を達成。700ワット構成でも31,303トークン/秒(オフライン)、30,128トークン/秒(サーバー)と、H100比で50%の性能向上を実現しています。
また、Mixtral 8x7Bの56億パラメータLLMでは、NVIDIA H100とH200がそれぞれ最大59,022トークン/秒、52,416トークン/秒を達成。AMDのInstinct MI300Xはこのワークロードで結果の提出がありませんでした。Stable Diffusion XLでも、NVIDIAのフルスタック最適化により、Hopperチップの性能が最大27%向上した一方、AMDはまだこのワークロードでのMLPerf提出を行っていません。
| ベンチマーク | GPU | サーバー | オフライン |
|---|---|---|---|
| Llama 2 70B | 8 H200 | 32,790 トークン/秒 | 34,864 トークン/秒 |
| Mixtral 8x7B | 8 H200 | 57,177 トークン/秒 | 59,022 トークン/秒 |
| GPT-J | 8 H200 | 19,243 トークン/秒 | 20,086 トークン/秒 |
| Stable Diffusion XL | 8 H200 | 16.78 クエリ/秒 | 17.42 サンプル/秒 |
| DLRM v2 99% | 8 H200 | 585,208 クエリ/秒 | 637,342 サンプル/秒 |
| DLRM v2 99.9% | 8 H200 | 370,083 クエリ/秒 | 390,953 サンプル/秒 |
| ResNet-50 v1.5 | 8 H200 | 632,229 クエリ/秒 | 756,960 サンプル/秒 |
| BERT 99% | 8 H200 | 57,609 クエリ/秒 | 73,310 サンプル/秒 |
| BERT 99.9% | 8 H200 | 51,212 クエリ/秒 | 63,950 サンプル/秒 |
| RetinaNet | 8 H200 | 13,604 クエリ/秒 | 14,439 サンプル/秒 |
| 3D U-Net | 8 H200 | ベンチマーク対象外 | 54.71 サンプル/秒 |
NVIDIAがMLPerfの各リリースで大幅な性能向上を実現できているのは、同社のソフトウェアを絶え間なく改良している成果です。このアドバンテージは、Hopper GPUを搭載したサーバーを運用する顧客に直接もたらされます。
我々が以前から主張してきたように、AIとデータセンターはハードウェアだけが全てではありません。ハードウェアも重要な要素ですが、それと同等かそれ以上に重要なのがソフトウェアです。いくら強力なハードウェアを持っていても、それを支えるソフトウェアがなければ意味がありません。AIインフラに多額の投資を行う企業は、エコシステム全体を見渡して判断を下すのです。
NVIDIAはそのエコシステムを整え、世界中の企業やAIパワーハウスにソリューションを提供する準備が整っています。だからこそ、同社は現在、各パートナー企業を通じてHGX H200の一般提供を発表しているのです。
MLPerf Inference v4.1の結果は、NVIDIAの技術革新の力強さを示すものでした。Blackwellの圧倒的な性能、Hopperの大幅な性能向上、Triton Inference ServerとTensorRT-LLMの効果など、ハードウェアとソフトウェアの両面でNVIDIAのテクノロジーがAI推論ワークロードを大きく前進させることが実証されました。
Blackwellが発売前からこれほど高い性能を示していることを考えると、Hopperがそうであったように、このAIに特化した新アーキテクチャがさらに進化し、来年後半のBlackwell Ultraに最適化の恩恵をもたらすことが期待できます。今後も、LLMやジェネレーティブAIの分野でNVIDIAの果たす役割に大きな注目が集まるでしょう。NVIDIAは、ハードウェアとソフトウェアの両面で絶え間ない改善を続けることで、AI分野における圧倒的な優位性を維持し、拡大し続けているのです。
只今、イメージセットを取得中です。

只今、イメージセットを取得中です。
只今、価格を取得しています。
(2026年9月13日 13:47 GMT +09:00 時点 - 詳細はこちら価格および発送可能時期は表示された日付/時刻の時点のものであり、変更される場合があります。本商品の購入においては、購入の時点で当該の Amazon サイトに表示されている価格および発送可能時期の情報が適用されます。)
只今、イメージセットを取得中です。